9. Från enkla modeller till dagens AI
Vi har använt modeller för att förutsäga cykeltider och skilja mellan pennor och suddgummin. Hur kan liknande grundidéer användas för att känna igen många olika föremål, skriva text och skapa nya bilder? I den här lektionen knyter vi ihop kapitlet och undersöker vad som blir möjligt när många beräkningar kopplas samman.
Vad har vi upptäckt i kapitlet?
I Regelroboten skrev ni regler som talade om hur datorn skulle agera i olika situationer. När ni tränade modellen i Teachable Machine visade ni istället exempel på pennor och suddgummin och angav vilken klass de tillhörde. Under träningen justerades modellens parametrar för att modellen skulle bli bättre på att skilja klasserna åt.
Cykelmodellen förutsäger en tid i minuter, alltså ett tal. Det kallas regression. Perceptronen gör en klassificering: den väljer mellan två klasser. Den väger samman sina indata och jämför summan med ett tröskelvärde. I båda modellerna innebär träning att parametrarna justeras med hjälp av exempel. När modellen sedan används på ny indata beräknar den sitt svar med de parametrar som träningen har gett.
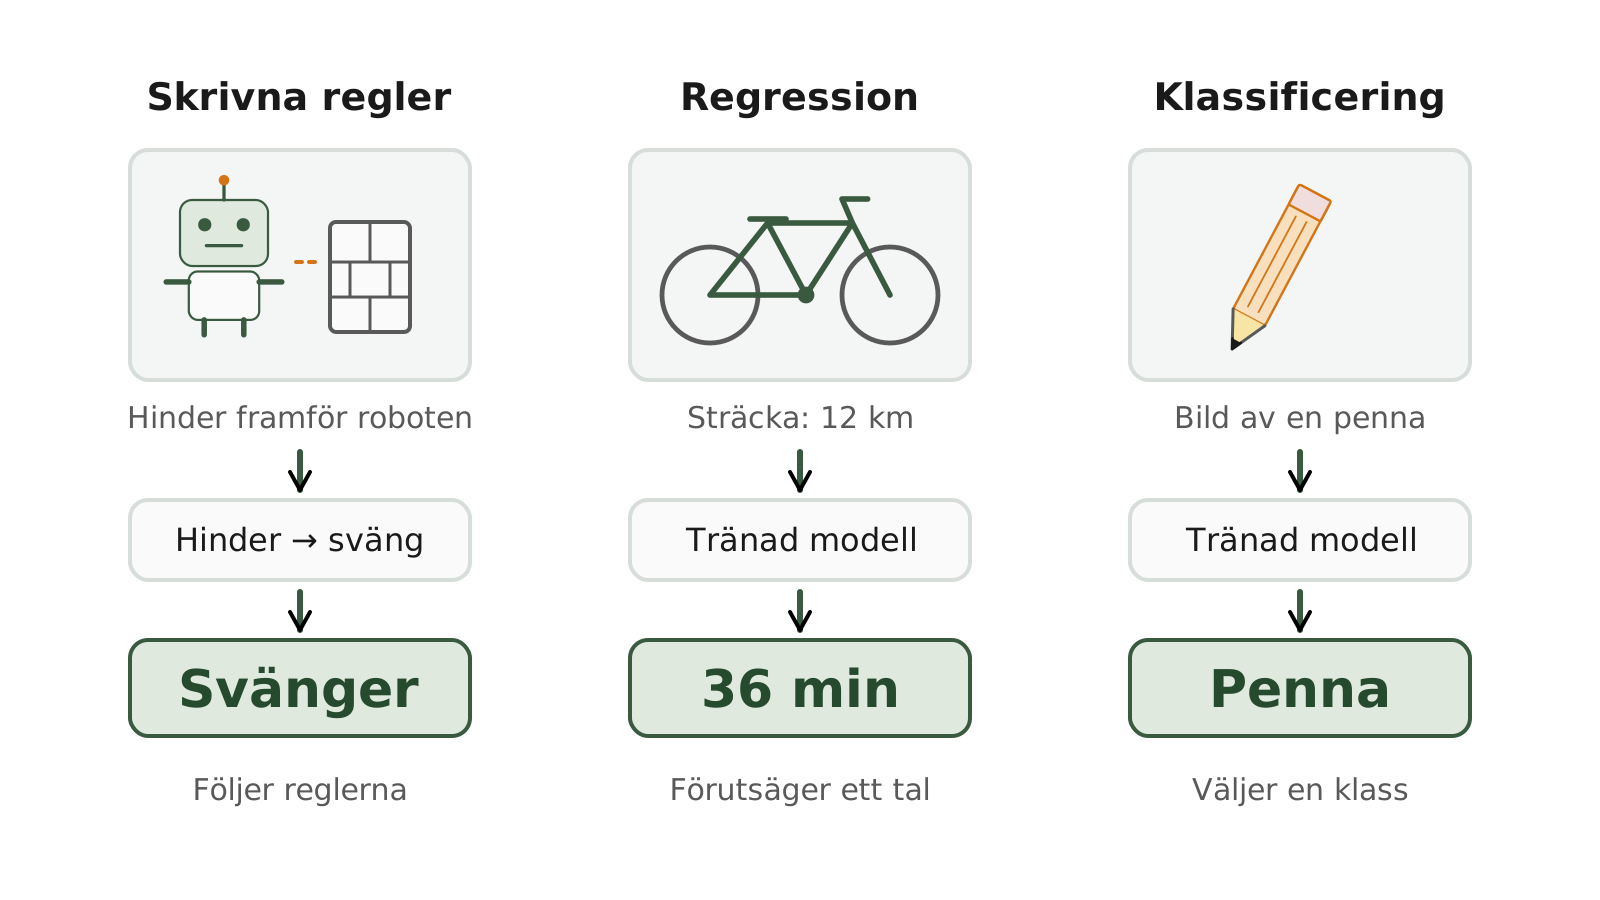
Regelroboten följer regler som vi skriver. De tränade modellerna använder parametrar som bestämts genom träning: cykelmodellen förutsäger ett tal och bildmodellen väljer en klass.
När beräkningar kopplas ihop
En perceptron är ett enkelt exempel på en artificiell neuron: den tar emot tal, gör en beräkning och lämnar ett resultat. I ett neuronnät kopplas flera artificiella neuroner samman. Resultatet från en neuron blir indata till andra neuroner, som bearbetar det vidare. På så sätt kan nätverket bearbeta information i flera steg.
Även i hjärnan arbetar nervceller i nätverk. Att känna igen ett ansikte eller förstå en mening bygger på att många nervceller samverkar. Artificiella neuronnät är inspirerade av den idén, men är mycket förenklade: deras neuroner är beräkningar i en dator, medan hjärnans nervceller är levande celler som kommunicerar med elektriska och kemiska signaler.
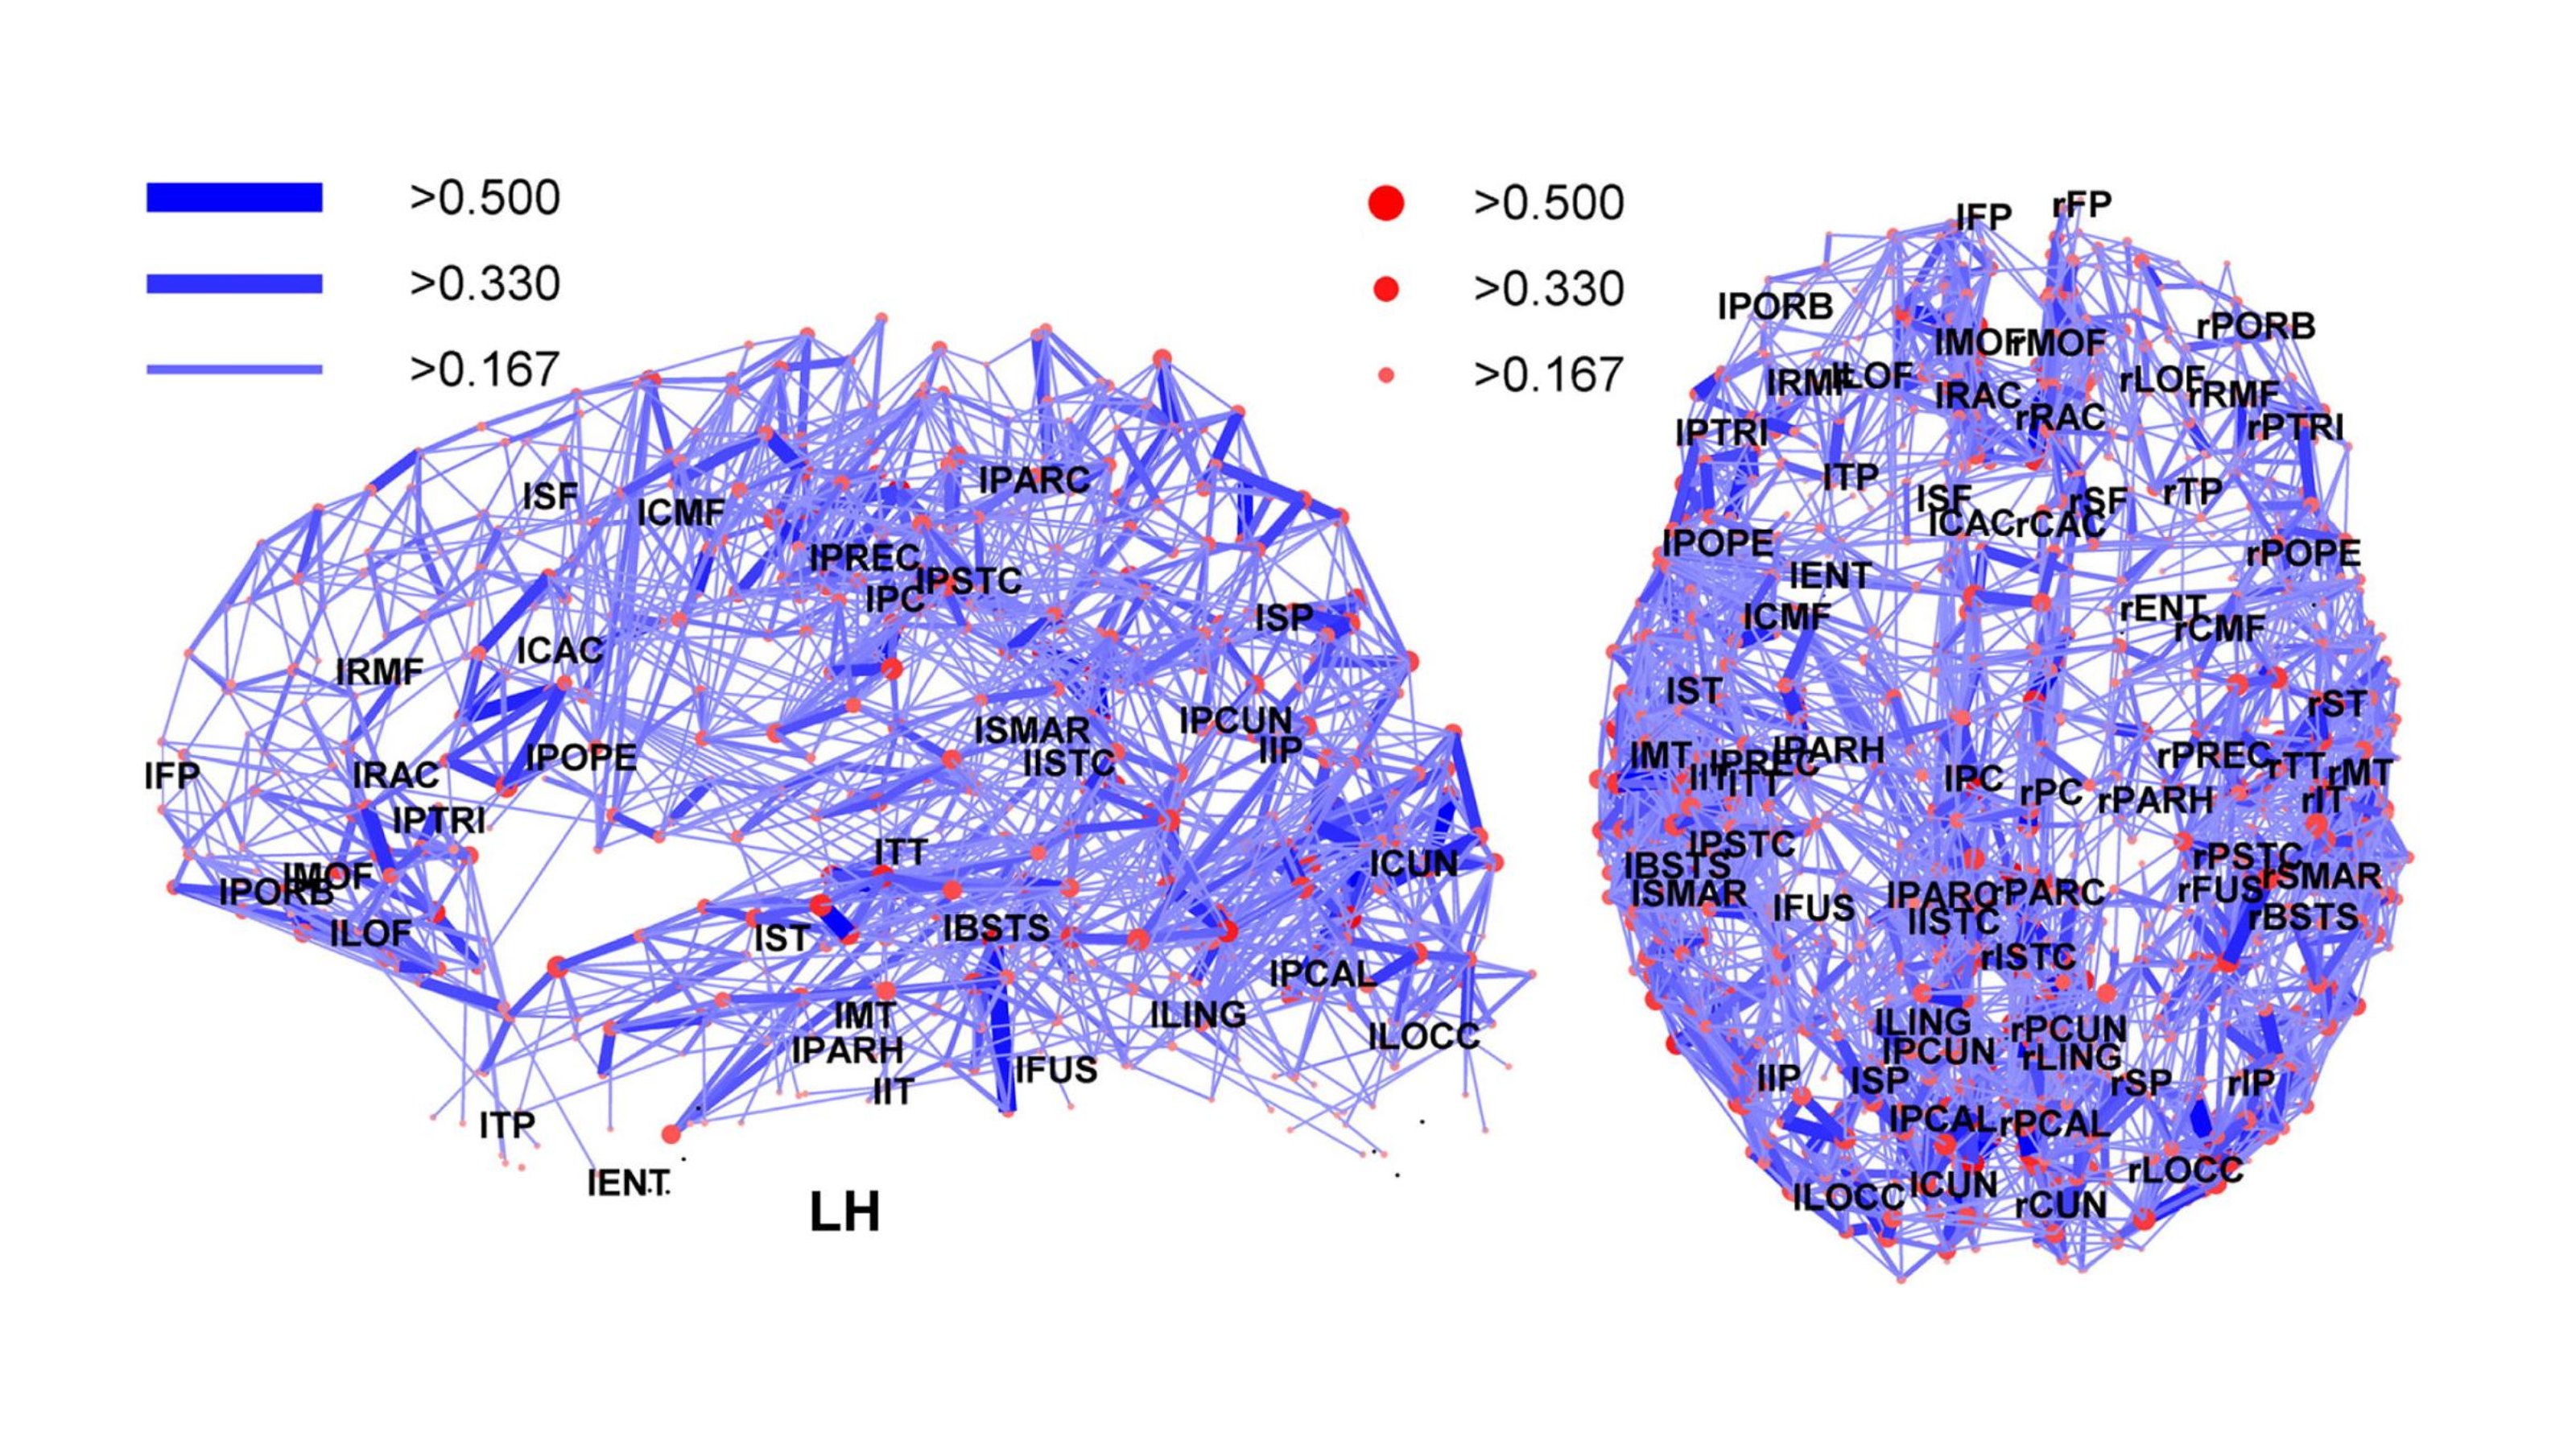
Bilden visar kopplingar mellan olika hjärnområden. Punkterna representerar områden och linjerna deras förbindelser.
Neuronerna i ett nätverk kan ordnas i lager. Ett lager består av flera neuroner som arbetar i samma steg av beräkningen. Det första lagret av neuroner tar emot modellens indata, till exempel talen som beskriver en bild. Nästa lager använder resultaten från det första och bearbetar dem vidare. Till sist beräknar det sista lagret nätverkets utdata, till exempel vilken klass bilden tillhör.
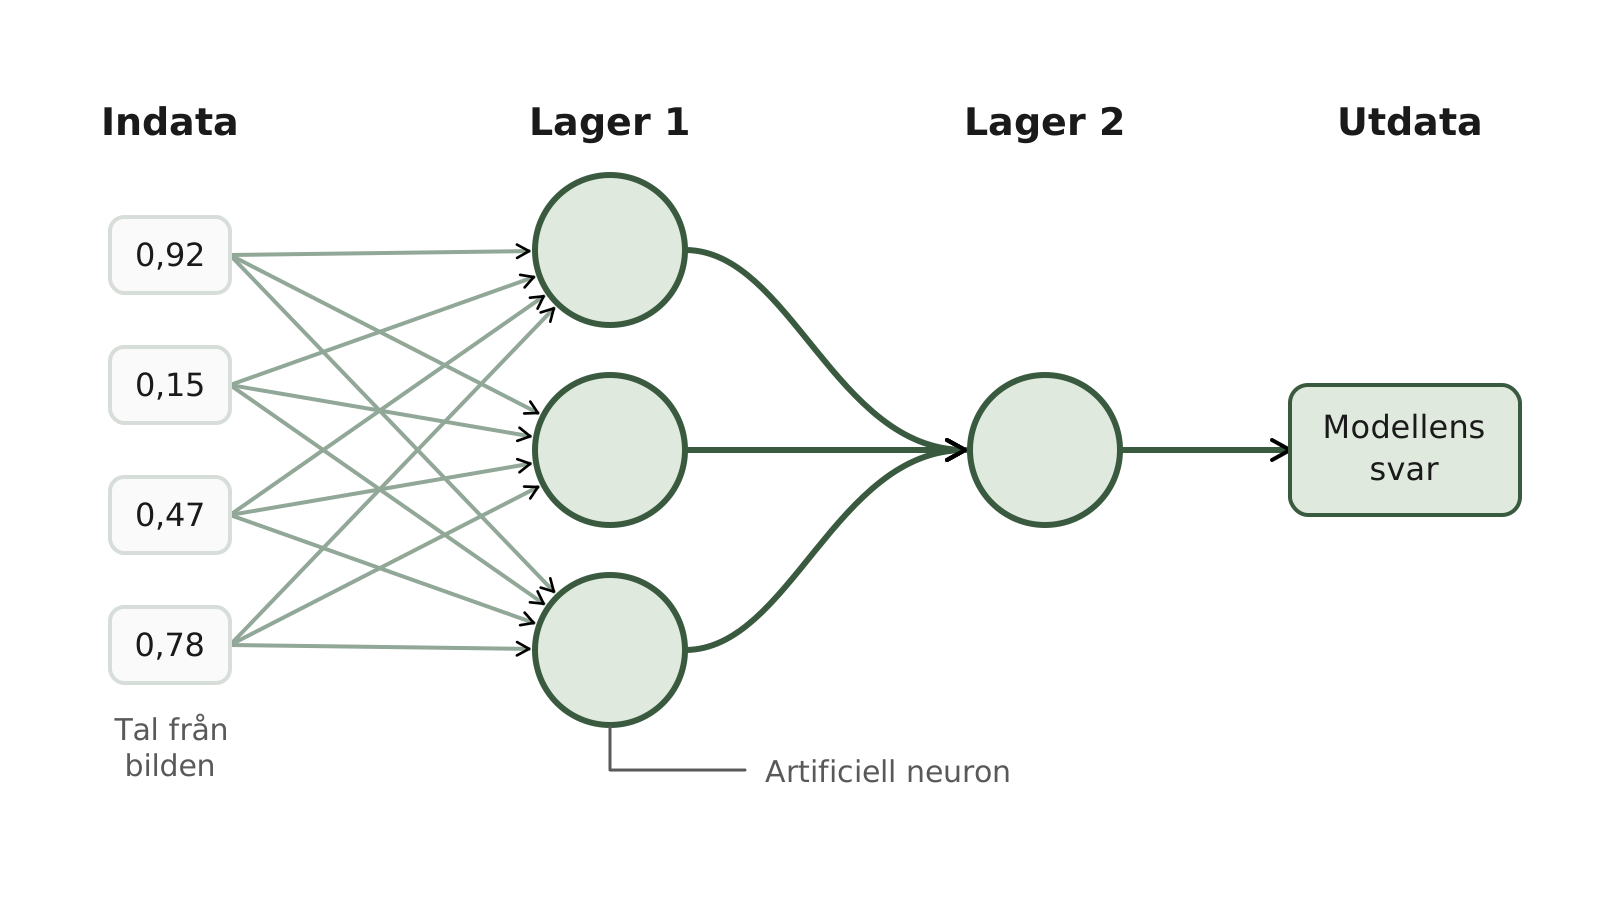
Neuronerna i ett lager skickar sina resultat vidare till nästa. Det sista lagret beräknar modellens svar.
En ensam perceptron kan inte lösa alla problem. Trappbelysningen i övningen var ett sådant exempel, oavsett hur vikterna ställdes in.
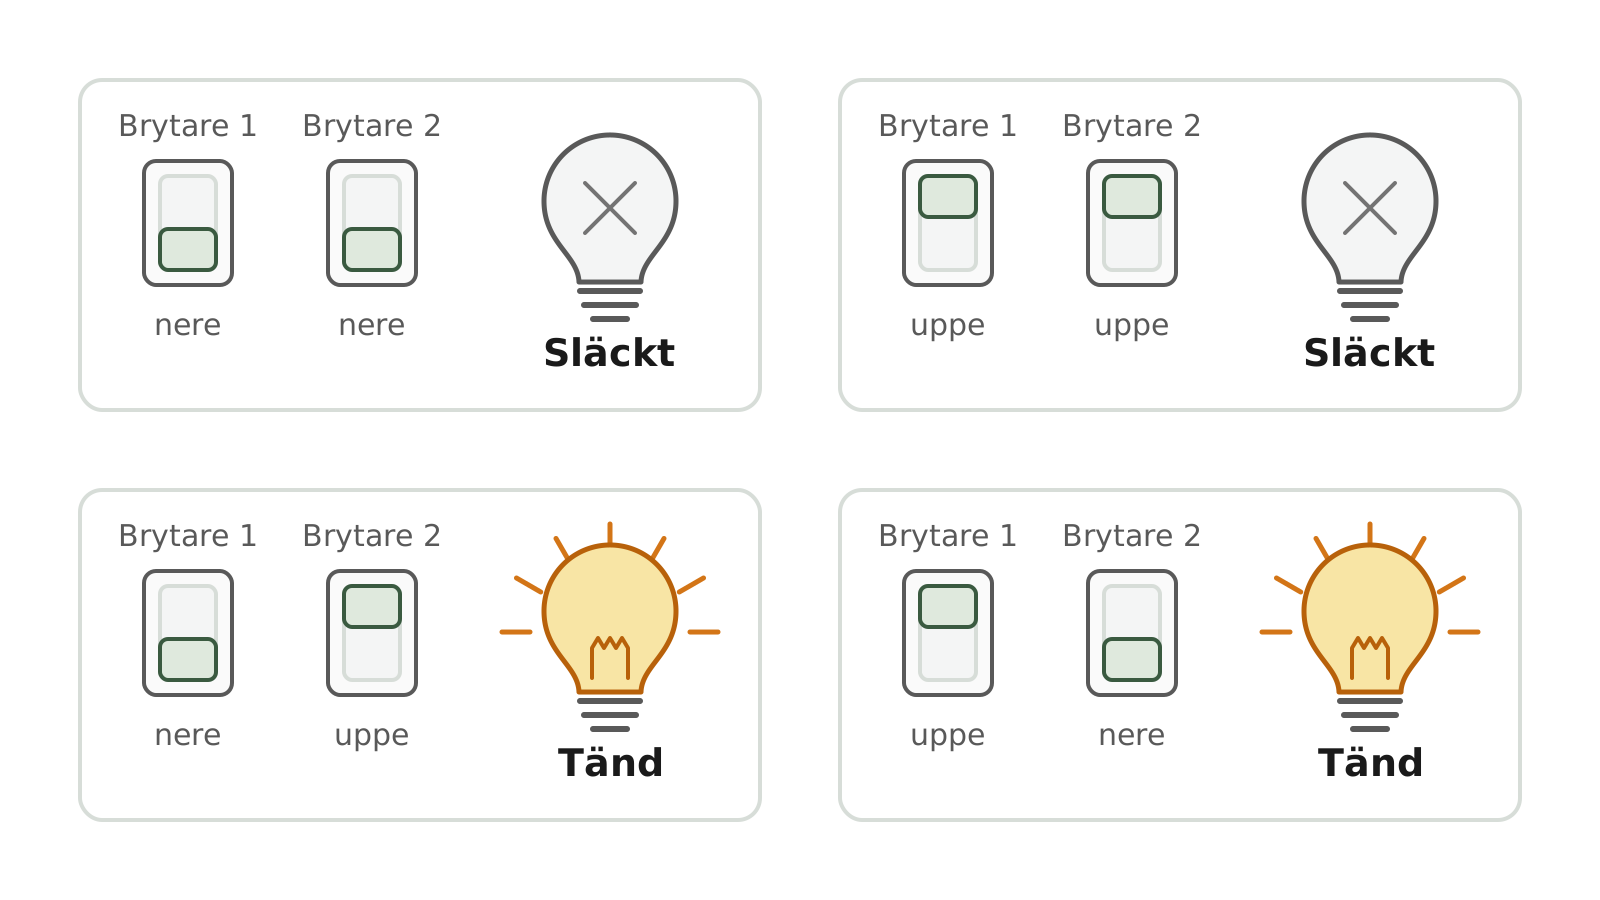
Lampan lyser när brytarna står olika. En ensam perceptron kunde inte lära sig att ge rätt svar i alla fyra fallen.
Från pixlar till bildigenkänning
En bild består av pixlar, vars färger beskrivs med tal. Dessa tal blir nätverkets indata. I ett bildnätverk kan de första lagren reagera på enkla mönster, som kanter och färgskillnader. Senare lager kan kombinera dessa till mer sammansatta mönster, som former och delar av föremål. Till sist används resultaten för att avgöra vilken klass bilden tillhör, till exempel penna eller suddgummi.1
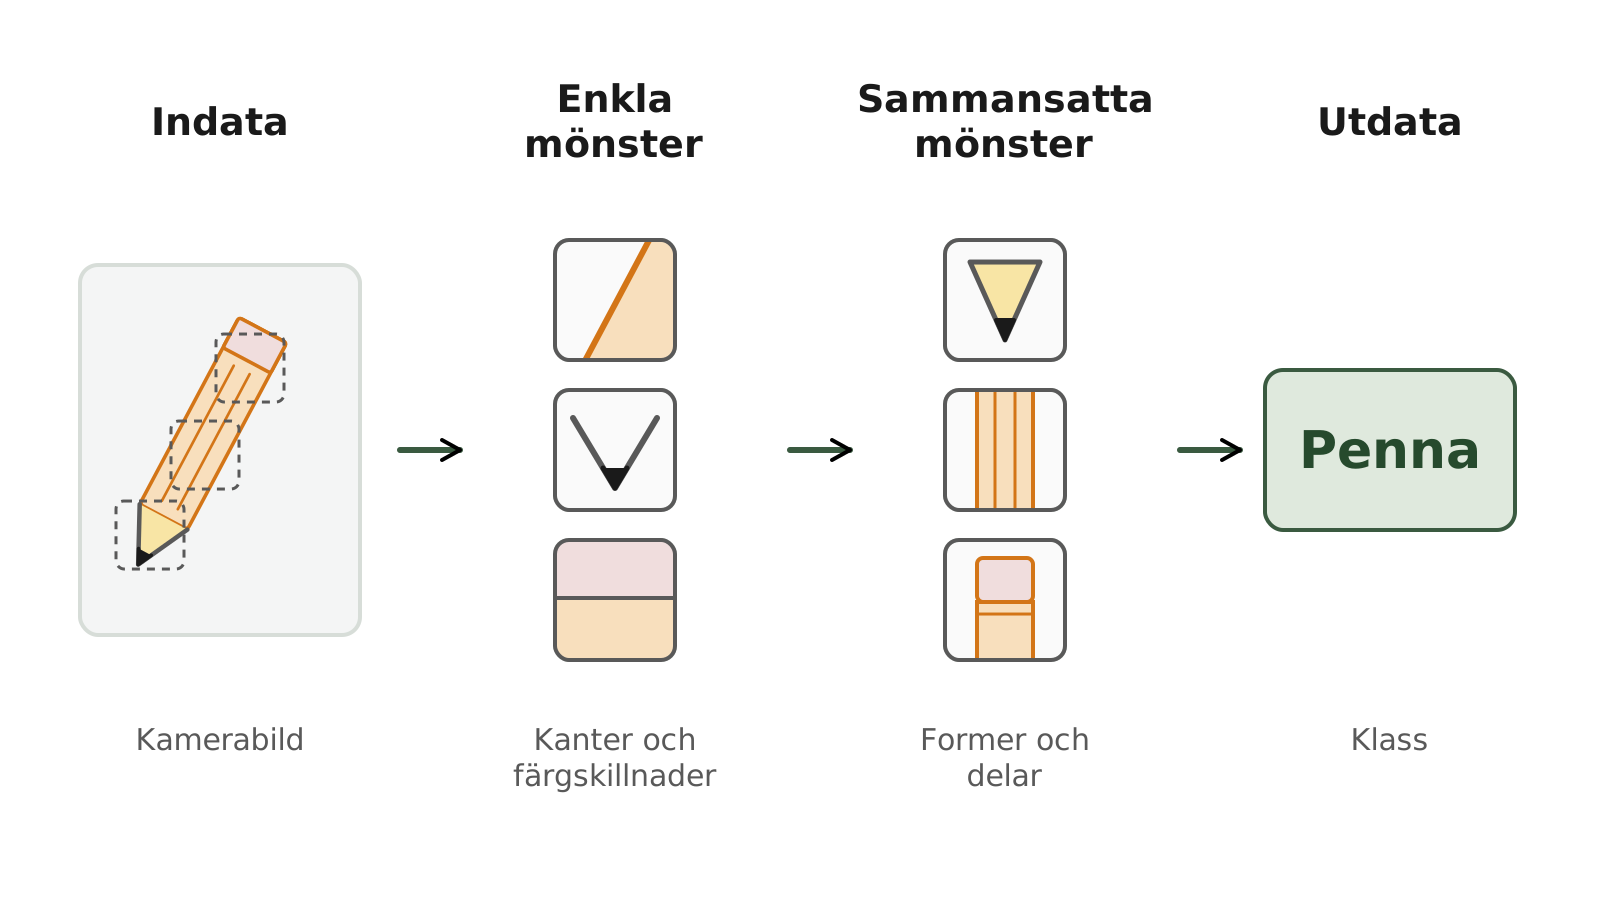
Enkla mönster kan kombineras till mer sammansatta mönster som hjälper nätverket att välja en klass. Bilden visar principen förenklat.
Det är genom träning som nätverket lär sig vilka mönster som är användbara. Vikterna justeras med hjälp av exempel, så att nätverkets svar blir mer träffsäkra. Vi behöver alltså inte skriva en regel för varje kant, form eller föremål. Efter träningen använder nätverket de inlärda vikterna när det får en ny bild.
Olika indata kan påverka utdata olika mycket. I en viktad summa bestämmer vikten hur stort bidrag varje extra enhet av en indata ger. Tänk dig en biokväll med påhittade priser: en biljett kostar 120 kronor och en portion popcorn 40 kronor. Antalet biljetter multipliceras med 120 och antalet popcornportioner med 40. En extra biljett ökar alltså totalpriset tre gånger så mycket som en extra portion popcorn.
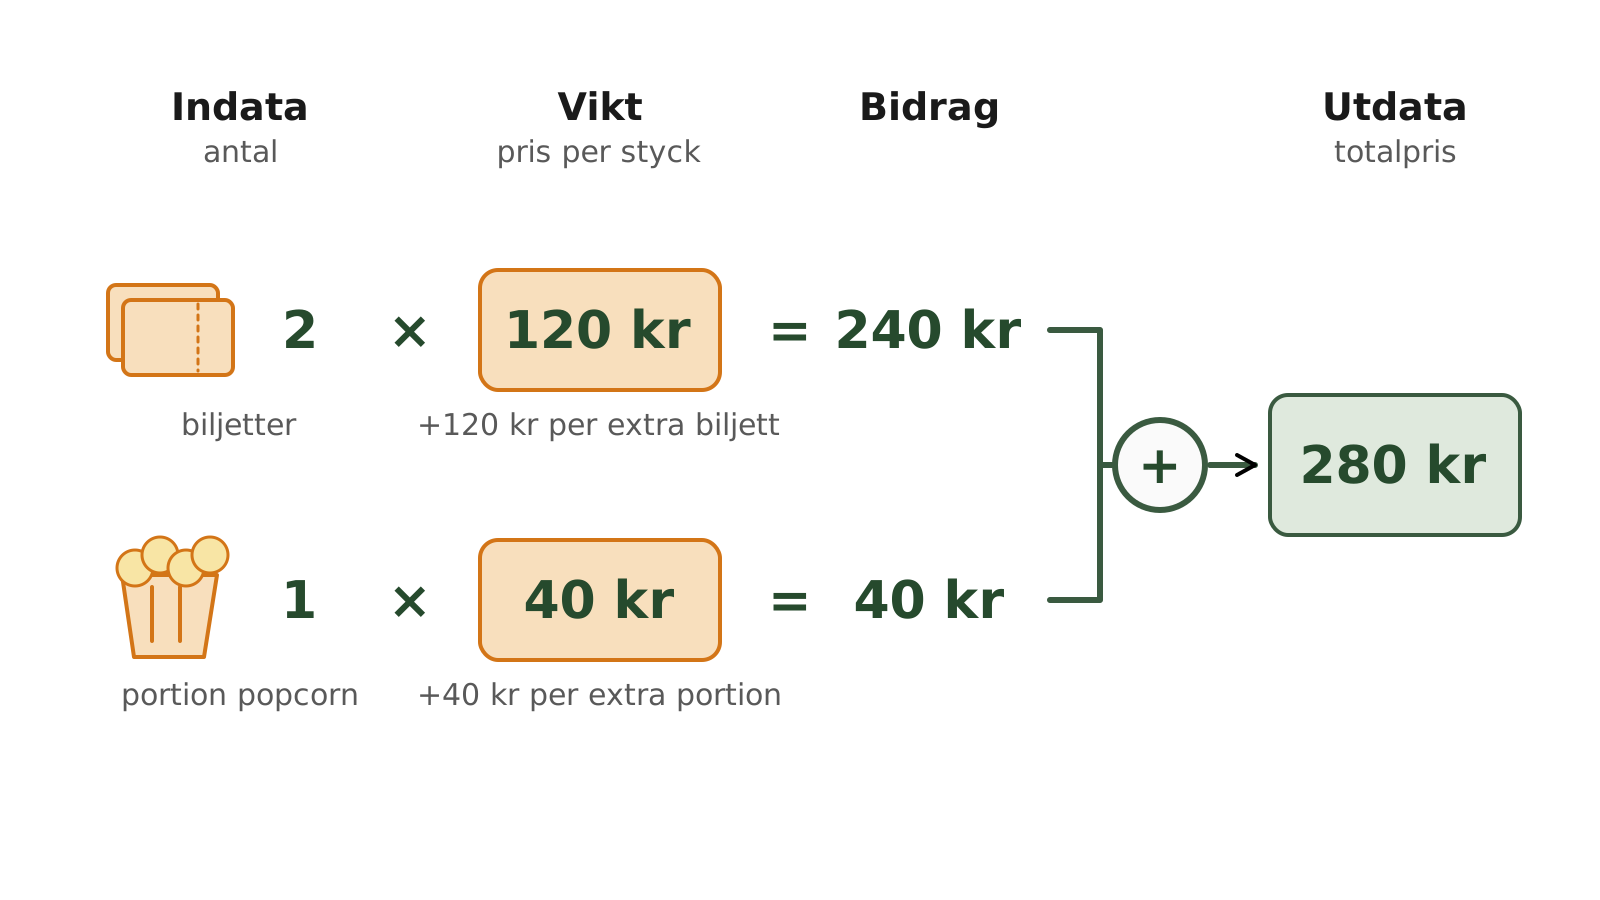
En extra biljett ökar totalpriset med 120 kronor, medan en extra portion popcorn ökar det med 40 kronor. Vikterna bestämmer hur mycket varje extra köp bidrar till summan.
Vikterna är parametrar som styr hur mycket olika indata bidrar till summan. I prisexemplet känner vi redan vikterna. I ett neuronnät bestäms vikterna genom träning. Principen är densamma: varje indata multipliceras med sin vikt innan bidragen summeras.
Fler neuroner ger inte automatiskt bättre resultat. Nätverket behöver testas på bilder som inte användes under träningen, till exempel nya foton av pennor och suddgummin. Då ser vi om det har lärt sig mönster som fungerar även på nya exempel.
Samma grundidéer i andra AI-system
Stora språkmodeller (LLM) kan generera text. Diffusionsmodeller är ett exempel på modeller som kan generera bilder. Båda bygger också på neuronnät, där många beräkningar kopplas ihop och parametrarna bestäms genom träning. Nätverken är betydligt mer omfattande och uppbyggda på andra sätt än våra enkla exempel, men grundidéerna återkommer.23
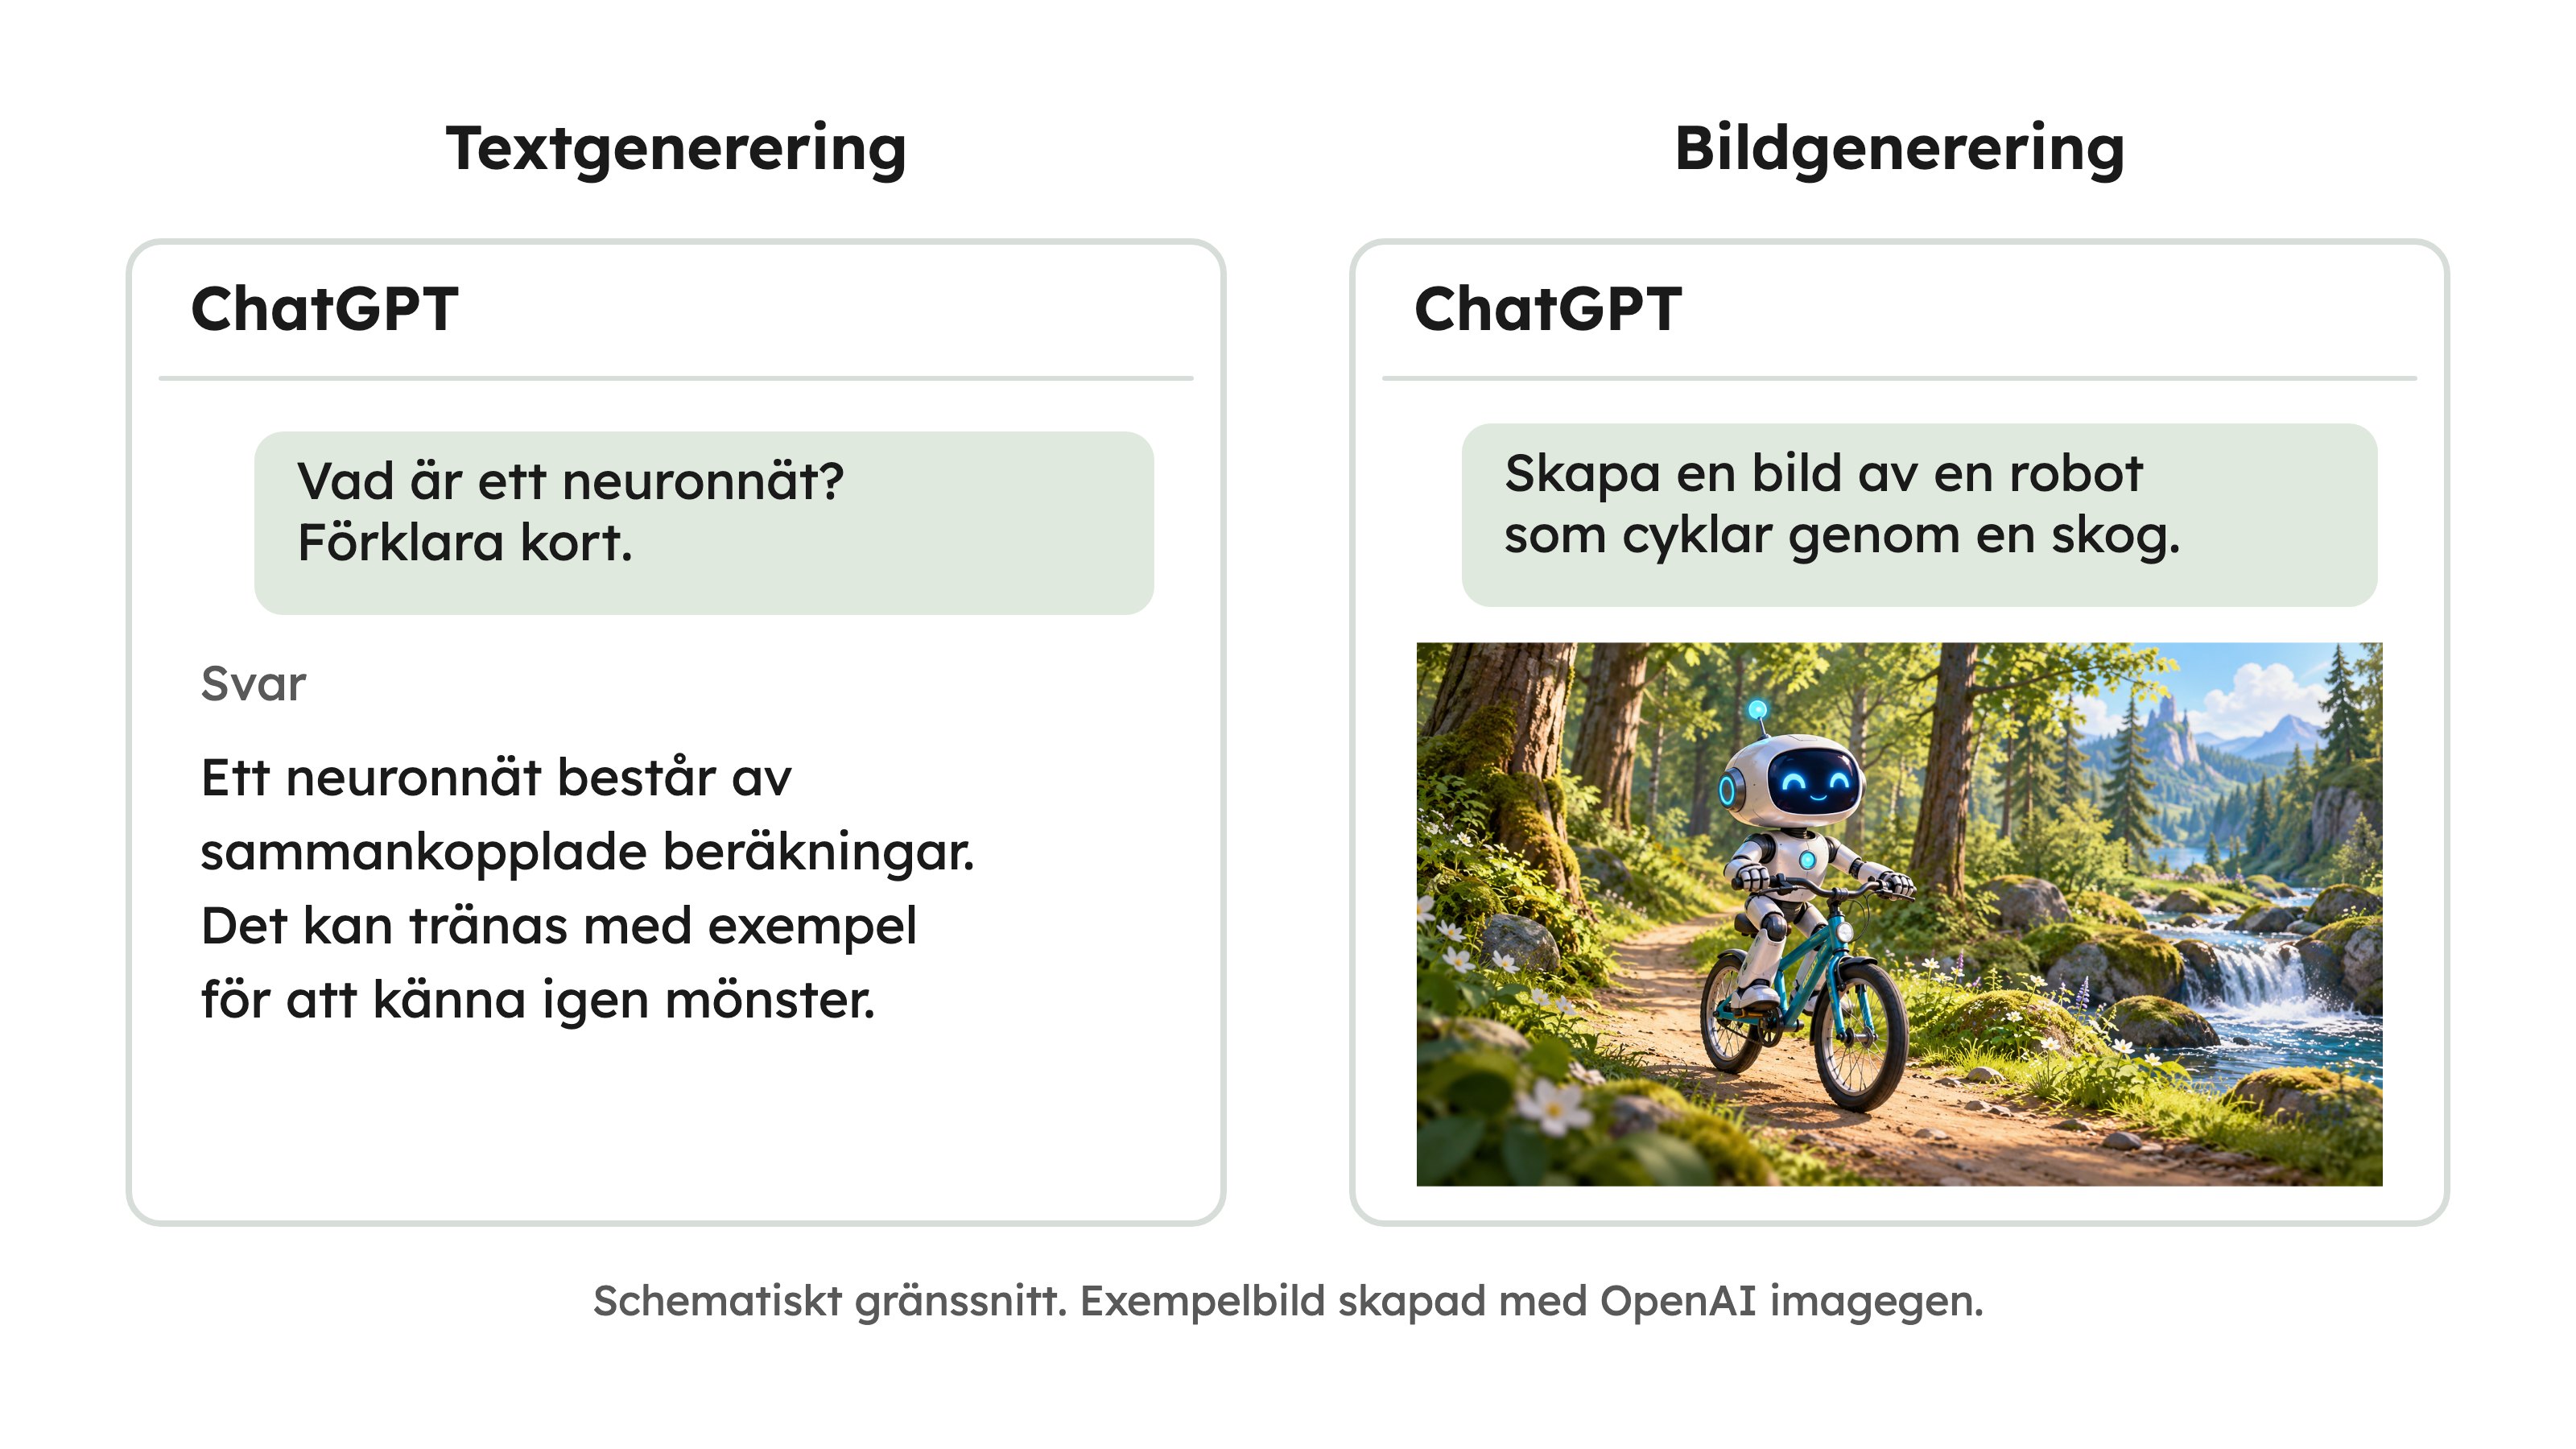
Textgenerering och bildgenerering är två tillämpningar av generativ AI. Stora språkmodeller (LLM) kan generera text. Diffusionsmodeller är exempel på modeller som kan generera bilder. Båda funktionerna kan finnas i samma AI-tjänst.
Sammanfattning: vad är gemensamt?
- Regression förutsäger ett tal, medan klassificering väljer en klass.
- Träning innebär att modellens parametrar justeras med hjälp av exempel.
- Vikter styr hur mycket olika indata bidrar till en beräkning.
- I ett neuronnät kopplas beräkningar ihop i lager. Enkla mönster kan kombineras till mer sammansatta mönster.
- Modellen testas på nya exempel för att undersöka hur väl det den lärt sig fungerar.
- Samma grundidéer kan utvecklas och skalas upp till mer omfattande neuronnät, som används i stora språkmodeller (LLM) och diffusionsmodeller.
Källor
Fotnoter
-
Matthew D. Zeiler och Rob Fergus, Visualizing and Understanding Convolutional Networks, arXiv, 2013, särskilt avsnitt 4, ”Convnet Visualization”, originalartikeln med visualiseringar av mönster i olika lager. Artikeln är på engelska och ger en mer teknisk förklaring för den som vill läsa vidare. ↩
-
Google, Machine Learning Crash Course: LLMs — What’s a large language model?, Google for Developers. En mer teknisk genomgång på engelska för den som vill läsa vidare. ↩
-
Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser och Björn Ommer, High-Resolution Image Synthesis with Latent Diffusion Models, CVPR, 2022, originalartikeln på arXiv. Artikeln är på engelska och beskriver bildgenerering med diffusionsmodeller på en betydligt mer teknisk nivå än lektionen. ↩